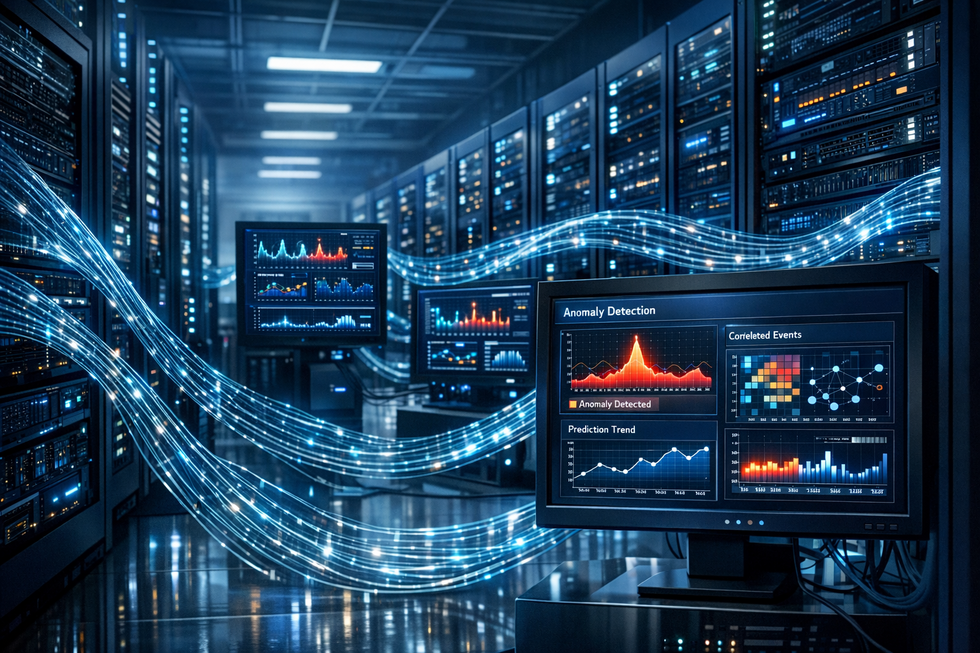
Monitorización avanzada en un centro de datos. Los paneles analizan flujos de información y detectan anomalías en tiempo real.
¿Cómo usar herramientas de IA para predecir cuándo tu servidor está a punto de caerse? ⚙️🤖
Un servidor rara vez se desploma “de repente”. Antes de caer, murmura. La CPU respira con dificultad, la base de datos acumula consultas como platos sucios, la memoria se llena en silencio y los tiempos de respuesta se estiran como sombras al atardecer. La inteligencia artificial no escucha profecías: escucha esos murmullos.
Durante años, muchos propietarios de sitios web han vivido bajo una curiosa superstición moderna: si el servidor no se ha caído hoy, entonces todo va bien. Es una fe conmovedora, casi medieval, solo que con paneles de hosting y certificados SSL. La realidad es menos piadosa. Los servidores fallan, los picos de tráfico llegan sin pedir permiso, los plugins de WordPress envejecen, las bases de datos se fragmentan y una campaña de marketing enviada a las nueve de la mañana puede convertir una infraestructura aparentemente digna en un castillo de naipes con ventiladores.
La buena noticia es que ya no estamos condenados a enterarnos del desastre por un cliente enfadado, un formulario roto o un mensaje en Slack escrito con demasiadas mayúsculas. Las herramientas de IA para monitoreo de servidores, observabilidad y AIOps permiten detectar patrones anómalos, anticipar saturaciones y emitir alertas predictivas antes de que el sitio quede fuera de servicio. No hacen magia. Hacen algo mucho más útil: comparan el comportamiento actual con miles o millones de señales pasadas y responden a una pregunta incómoda: ¿esto se parece al principio de una caída?
En esta guía veremos:
- Qué puede predecir realmente la IA sobre un servidor
- Qué métricas debes vigilar para anticipar caídas
- Herramientas profesionales de IA y AIOps
- Cómo aplicarlo en WordPress, WooCommerce y sitios empresariales
- Un plan de implementación paso a paso
- Errores frecuentes y falsas promesas
La IA no predice el futuro: calcula probabilidades con buenos modales 🔮
Conviene empezar con una precisión técnica, porque en tecnología las palabras exageradas se venden mejor que las precisas, y ahí empieza buena parte del problema. Una herramienta de IA no puede afirmar con certeza: “tu servidor caerá el jueves a las 16:07”. Si alguien lo promete, quizá también venda paraguas contra meteoritos.
Lo que sí puede hacer es detectar tendencias peligrosas, anomalías y correlaciones que suelen preceder a un incidente. Por ejemplo: aumento gradual del uso de memoria sin liberación posterior, crecimiento inusual de consultas lentas en MySQL, incremento de errores 502 en Nginx, saturación de procesos PHP-FPM, latencia ascendente en disco, agotamiento de conexiones disponibles o reinicios repetidos de contenedores.
La diferencia es crucial. El monitoreo tradicional mira umbrales: “avísame cuando la CPU supere el 90%”. La IA observa comportamiento: “este servidor suele estar al 75% cada lunes a las 10:00, pero hoy, con menos tráfico, está al 82%, la latencia sube y la memoria no baja; algo no encaja”. Es como pasar de un vigilante que solo grita cuando ve humo a un bombero veterano que huele el cable quemado antes de que aparezca la llama.
1
Detección de anomalías
Identifica comportamientos fuera de lo normal aunque no superen un umbral fijo. Muy útil para tráfico estacional, campañas, sitios con horarios variables y tiendas online.
2
Predicción de capacidad
Estima cuándo CPU, memoria, almacenamiento, conexiones o procesos alcanzarán niveles críticos si la tendencia continúa.
3
Correlación de eventos
Relaciona métricas, logs y trazas para distinguir síntomas de causas: no es lo mismo “la web va lenta” que “la base de datos está bloqueando escrituras”.
Las señales que anuncian una caída antes de que el usuario la vea 📉
Un sitio web no cae de una sola manera. Puede caer con estruendo, mostrando un error 500 como una puerta cerrada en la cara. O puede hacerlo con una lentitud cruel: páginas que tardan diez segundos, carritos que no cargan, formularios que envían dos veces, administradores de WordPress que parecen caminar sobre barro. Técnicamente sigue “online”. Comercialmente, ya está muerto.
Para que la IA sea útil, necesita datos. No datos decorativos, sino telemetría seria: métricas, logs, trazas, eventos de despliegue, comportamiento de usuarios, errores de aplicación y estado de infraestructura. La inteligencia artificial sin buena observabilidad es como un médico examinando a un paciente a través de una cortina.
Métricas del sistema operativo
- CPU: uso total, carga media, steal time en entornos virtualizados y saturación por proceso.
- Memoria: RAM libre, swap usado, page faults y crecimiento sostenido de procesos.
- Disco: IOPS, latencia de lectura/escritura, espacio disponible, inode usage y errores SMART en servidores físicos.
- Red: ancho de banda, retransmisiones TCP, conexiones abiertas, paquetes descartados y latencia.
Métricas del servidor web
- Nginx o Apache: errores 499, 500, 502, 503 y 504; tiempo de respuesta; workers activos; solicitudes por segundo.
- PHP-FPM: procesos activos, cola de espera,
max_childrenalcanzado y tiempos de ejecución. - Node.js, Python, Ruby o Java: uso de event loop, threads, garbage collection, memoria heap, pool de conexiones.
Métricas de base de datos
- MySQL/MariaDB: consultas lentas, locks,
Threads_running, conexiones máximas, buffer pool de InnoDB, tamaño de tablas temporales. - PostgreSQL: locks, autovacuum, bloat, conexiones activas, consultas largas y latencia de escritura.
- Redis/Memcached: hit ratio, memoria usada, evictions, latencia y fragmentación.
Métricas de aplicación y experiencia real
- Tasa de errores: errores 4xx y 5xx, excepciones de PHP, fallos de API, errores JavaScript.
- Latencia: p95 y p99, no solo promedio. El promedio suele ser un diplomático: dice poco y tranquiliza demasiado.
- Core Web Vitals: LCP, INP y CLS para evaluar experiencia de usuario.
- Transacciones críticas: login, checkout, búsqueda, envío de formularios, carga del panel de administración.
Idea clave: una caída no empieza cuando el sitio deja de responder. Empieza cuando las señales dejan de comportarse como deberían. La IA es útil porque puede detectar esas desviaciones antes de que se conviertan en incidente.
Monitoreo tradicional vs. monitoreo predictivo con IA ⚖️
El monitoreo clásico tiene una virtud noble: es sencillo. También tiene una debilidad evidente: llega tarde. Si tu alerta se dispara cuando el disco ya está al 95%, no estás previniendo un problema; estás viendo cómo el problema se pone el abrigo para salir a escena.
| Enfoque | Cómo funciona | Ventaja | Limitación |
|---|---|---|---|
| Umbrales estáticos | Alertas cuando una métrica supera un valor fijo: CPU > 90%, disco > 85%. | Fácil de configurar y entender. | Genera falsos positivos o llega tarde en sistemas con patrones variables. |
| Umbrales dinámicos | El sistema aprende valores normales por hora, día o temporada. | Más preciso para tráfico cambiante. | Requiere historial suficiente y buena calidad de datos. |
| Detección de anomalías | Modelos estadísticos o de machine learning detectan desviaciones multivariable. | Encuentra problemas sutiles antes del fallo visible. | Puede requerir ajuste para evitar ruido operativo. |
| AIOps | Correlaciona métricas, logs, trazas, eventos y cambios de infraestructura. | Ayuda a identificar causa raíz y reducir tiempo de resolución. | Puede ser costoso y complejo si se implementa sin estrategia. |
La antítesis es clara: el monitoreo tradicional pregunta “¿ya se rompió?”, mientras el monitoreo predictivo pregunta “¿qué está empezando a romperse?”. Uno mira el cadáver; el otro busca el pulso irregular. Y en operaciones web, esa diferencia puede ser la distancia entre una interrupción de cinco minutos y una mañana entera perdida, con capturas de pantalla circulando por grupos de WhatsApp como pruebas forenses.
Herramientas de IA y AIOps para anticipar caídas de servidores 🧰
No existe una herramienta perfecta para todos los casos. Hay plataformas potentes para equipos DevOps grandes, opciones manejables para agencias y soluciones razonables para propietarios de sitios WordPress que no quieren convertirse en ingenieros de fiabilidad a tiempo completo. La elección depende de presupuesto, complejidad, volumen de tráfico y nivel de control sobre la infraestructura.
1. Datadog Watchdog
Datadog combina métricas, logs, trazas APM, monitoreo sintético y experiencia real de usuario. Su sistema Watchdog usa aprendizaje automático para detectar anomalías, correlacionar eventos y sugerir posibles causas. Es especialmente útil en arquitecturas modernas con contenedores, microservicios, Kubernetes y múltiples proveedores cloud.
Ideal para: empresas SaaS, ecommerce de alto tráfico, equipos con cultura DevOps y necesidad de visibilidad completa.
2. New Relic Applied Intelligence
New Relic ofrece observabilidad full-stack: infraestructura, aplicaciones, bases de datos, navegador, móviles y logs. Sus funciones de inteligencia aplicada ayudan a reducir ruido de alertas, detectar comportamientos anómalos y agrupar incidentes relacionados. Para sitios con backend complejo, APIs y transacciones críticas, puede ser una brújula bastante decente en medio de la niebla.
Ideal para: aplicaciones web con necesidad de APM, equipos de desarrollo que desean conectar rendimiento de código con estabilidad del servidor.
3. Dynatrace Davis AI
Dynatrace destaca por su motor Davis AI, diseñado para análisis causal automático. No se limita a decir que algo va mal; intenta explicar por qué. En entornos empresariales, esa diferencia importa. Detectar que la latencia sube es útil. Saber que sube por un cambio específico en un servicio, una consulta lenta o un nodo saturado es muchísimo mejor.
Ideal para: grandes organizaciones, infraestructura híbrida, Kubernetes, aplicaciones distribuidas y entornos con alta criticidad.
4. Elastic Stack con Machine Learning
Elastic permite centralizar logs, métricas y trazas, y sus capacidades de machine learning ayudan a detectar anomalías en series temporales. Es una opción muy poderosa cuando el equipo ya trabaja con Elasticsearch, Kibana, Beats o Elastic Agent. Requiere más criterio técnico, pero ofrece flexibilidad considerable.
Ideal para: equipos técnicos que quieren control detallado sobre logs, seguridad, búsquedas y análisis de anomalías.
5. Grafana, Prometheus y alertas inteligentes
Prometheus sigue siendo una pieza fundamental del monitoreo moderno. Por sí solo no es una “IA”, pero combinado con Grafana, Grafana Machine Learning, Mimir, Loki, Tempo o integraciones externas puede formar una plataforma robusta de observabilidad predictiva. Es una elección habitual en Kubernetes y sistemas cloud-native.
Ideal para: equipos que prefieren herramientas open source, alta personalización y control sobre costes.
6. Zabbix con funciones predictivas
Zabbix permite configurar triggers predictivos mediante funciones como estimaciones de tiempo para alcanzar ciertos valores. No es tan glamuroso como algunas plataformas AIOps —no presume de futurismo en cada esquina—, pero es sólido, conocido y muy capaz para infraestructura tradicional.
Ideal para: agencias, administradores de sistemas, empresas con servidores dedicados, VPS y entornos mixtos.
7. Servicios cloud con detección de anomalías
AWS CloudWatch Anomaly Detection, Azure Monitor, Google Cloud Monitoring y servicios equivalentes permiten aplicar modelos sobre métricas de infraestructura. Si tu sitio vive en la nube, aprovechar las herramientas nativas suele ser el camino más rápido para empezar.
Ideal para: proyectos alojados en AWS, Azure o Google Cloud que necesitan monitoreo predictivo sin desplegar demasiada infraestructura adicional.
8. Splunk ITSI
Splunk IT Service Intelligence es una opción empresarial para correlación de eventos, salud de servicios y análisis predictivo. Es potente, sí. También puede sentirse como entrar en una cabina de avión para encender una lámpara. Pero cuando la operación es grande, esa cabina tiene sentido.
Ideal para: organizaciones con gran volumen de logs, requisitos de cumplimiento, seguridad y operaciones críticas.
Advertencia útil: no elijas una herramienta solo porque incluya “AI” en la página de ventas. Evalúa qué datos recoge, cómo detecta anomalías, si permite explicar causas, cuánto cuesta almacenar logs y qué tan rápido puede integrarse con tu stack real.
Aplicación práctica en WordPress y WooCommerce 🛒
WordPress merece un capítulo aparte porque, seamos honestos, buena parte de la web mundial funciona sobre él con una mezcla admirable de flexibilidad, plugins, temas, optimismo y alguna oración pagana. WordPress puede ser rápido, seguro y estable. También puede convertirse en una criatura pesada si se instala todo lo que promete “mejorar conversiones” con la delicadeza de un piano cayendo por las escaleras.
En WordPress, las caídas suelen estar relacionadas con una combinación de factores:
- Plugins mal optimizados o incompatibles.
- Consultas lentas en
wp_postmeta,wp_optionso tablas de WooCommerce. - Falta de caché de página, objeto o navegador.
- WP-Cron ejecutándose en momentos inoportunos.
- Picos de tráfico por campañas, lanzamientos, bots o ataques.
- Procesos PHP-FPM agotados.
- Base de datos sin mantenimiento, índices insuficientes o autoload excesivo.
- Backups, escaneos de seguridad o importaciones ejecutándose en horas pico.
Señales específicas que una IA debería observar en WordPress
| Señal | Por qué importa | Riesgo si empeora |
|---|---|---|
Tiempo de respuesta de /wp-admin/ |
El panel suele mostrar problemas de PHP, base de datos o plugins antes que el frontend cacheado. | Administración inutilizable, publicaciones fallidas, pedidos atascados. |
| Consultas lentas en WooCommerce | Carrito, checkout y pedidos dependen intensamente de la base de datos. | Pérdida directa de ventas y abandonos de compra. |
| Aumento de procesos PHP-FPM activos | Indica que las solicitudes tardan más en completarse. | Errores 502/504 y cola de solicitudes. |
| Crecimiento de opciones autoload | WordPress carga opciones autoload en cada solicitud. | Más memoria, mayor latencia, degradación progresiva. |
| Errores recurrentes en logs de PHP | Warnings y fatals pueden preceder fallos visibles. | Páginas blancas, funciones rotas, inestabilidad. |
Para un sitio WordPress profesional, la IA no debería limitarse a mirar si “la web responde”. Debe evaluar el camino completo: DNS, CDN, servidor web, PHP, base de datos, caché, APIs externas y experiencia del usuario. Un checkout puede fallar aunque la home cargue velozmente. Es como juzgar un restaurante por la fachada mientras la cocina arde con una serenidad ofensiva.
Cómo funcionan los modelos predictivos detrás del monitoreo inteligente 🧠
No hace falta ser científico de datos para beneficiarse de estas herramientas, pero entender lo básico ayuda a no comprar humo en envase premium. Los sistemas predictivos suelen combinar varias técnicas:
Modelos de series temporales
Analizan datos a lo largo del tiempo: CPU por minuto, latencia por segundo, errores por hora. Métodos como ARIMA, Prophet o modelos estadísticos similares pueden reconocer estacionalidad: más tráfico los lunes, menos actividad de madrugada, picos durante campañas.
Detección de anomalías
Algoritmos como Isolation Forest, clustering, modelos basados en desviación estándar, autoencoders o enfoques probabilísticos detectan comportamientos raros. La clave no es solo saber que una métrica sube, sino si sube de una forma inusual respecto a su historia y contexto.
Modelos supervisados
Si tienes incidentes históricos etiquetados —por ejemplo, “caída por saturación de base de datos”, “error por falta de memoria”, “ataque bot”— se pueden entrenar modelos para reconocer patrones parecidos. Esto es más potente, pero exige disciplina: registrar incidentes, causas, tiempos y cambios realizados.
Correlación multivariable
Las caídas rara vez dependen de una sola métrica. La CPU puede estar alta porque la base de datos responde lento; la base de datos puede responder lento porque el disco tiene latencia; el disco puede sufrir porque los backups coinciden con una campaña. Un buen sistema analiza relaciones, no solo números aislados.
En términos sencillos: la IA busca constelaciones, no estrellas sueltas. Una estrella puede ser bonita; una constelación cuenta una historia.
Plan paso a paso para predecir caídas antes de que ocurran 🚀
La teoría es agradable, pero los servidores no se mantienen estables con metáforas. Necesitas un plan. Y, preferiblemente, uno que no empiece comprando la herramienta más cara para descubrir tres meses después que nadie configuró los logs.
Paso 1: Define qué significa “caída” para tu negocio
No todas las interrupciones tienen el mismo peso. Para un blog corporativo, una lentitud de cinco minutos puede ser tolerable. Para una tienda WooCommerce durante Black Friday, dos minutos de checkout roto son una pequeña tragedia con factura.
Define indicadores como:
- Disponibilidad: porcentaje de uptime mensual.
- Tiempo de respuesta aceptable: por ejemplo, p95 por debajo de 800 ms en páginas clave.
- Tasa máxima de errores: porcentaje tolerable de respuestas 5xx.
- Transacciones críticas: compra completada, formulario enviado, login exitoso, búsqueda funcional.
- Objetivos SLO: compromisos internos de fiabilidad.
Paso 2: Instrumenta tu servidor y aplicación
Instala agentes o exportadores que recojan datos del sistema, servidor web, runtime, base de datos y aplicación. En entornos modernos, OpenTelemetry se ha convertido en un estándar importante para recolectar trazas, métricas y logs de forma interoperable.
Una arquitectura habitual puede verse así:
Servidor / Contenedor
 ├─ Métricas del sistema: CPU, RAM, disco, red
 ├─ Logs: Nginx, Apache, PHP, MySQL, aplicación
 ├─ Trazas APM: rutas lentas, consultas, llamadas externas
 ├─ Eventos: despliegues, cambios DNS, actualizaciones de plugins
 └─ Plataforma de observabilidad: Datadog, New Relic, Dynatrace, Elastic, Grafana, Zabbix...
Paso 3: Recoge historial suficiente
Un modelo predictivo necesita aprender qué es normal. Con una semana de datos puedes empezar a detectar patrones básicos. Con 30 a 90 días, el análisis mejora. Con varios meses, puedes identificar estacionalidad, campañas recurrentes, cierres contables, ciclos de nómina, lanzamientos y otras rarezas humanas que terminan reflejándose en la CPU, como si el servidor tuviera calendario emocional.
Paso 4: Configura alertas predictivas, no solo alarmas tardías
Evita depender exclusivamente de reglas como “CPU > 90%”. Añade alertas basadas en tendencia:
- “El disco alcanzará el 90% en menos de 48 horas si continúa el crecimiento actual”.
- “La tasa de errores 5xx es anómala para este horario”.
- “La latencia p95 subió un 40% respecto al patrón habitual del último mes”.
- “PHP-FPM se acerca a saturación aunque el tráfico no aumentó proporcionalmente”.
- “Las consultas lentas aumentaron después del último despliegue”.
Paso 5: Correlaciona alertas con cambios
Muchos incidentes no nacen de la nada; nacen de un cambio. Un plugin actualizado, una versión nueva de PHP, una regla de firewall, una migración de base de datos, una campaña de email, una importación CSV, un ajuste de caché. La IA funciona mejor si conoce esos eventos.
Registra automáticamente:
- Despliegues de código.
- Actualizaciones de WordPress, temas y plugins.
- Cambios en configuración de servidor.
- Activación o desactivación de CDN.
- Backups, tareas cron e importaciones masivas.
- Campañas de marketing y picos esperados.
Paso 6: Crea runbooks de respuesta
Una alerta inteligente sin procedimiento es solo una notificación elegante. Para cada riesgo, define una respuesta. Si el sistema predice saturación de base de datos, ¿quién actúa? ¿Se escala el servidor? ¿Se activa caché agresiva? ¿Se bloquean bots? ¿Se pausa una tarea cron? ¿Se habilita una réplica de lectura?
Ejemplo de runbook breve:
Alerta: Riesgo de saturación PHP-FPM en los próximos 20 minutos

1. Revisar tráfico actual y origen en CDN/WAF.
2. Comprobar errores 502/504 en Nginx.
3. Revisar slow logs de PHP y rutas más lentas en APM.
4. Verificar si hubo despliegue o actualización reciente.
5. Activar caché de emergencia para usuarios no autenticados.
6. Aumentar temporalmente workers si hay memoria suficiente.
7. Escalar horizontalmente o verticalmente si el patrón continúa.
8. Documentar causa y acción tomada.
Paso 7: Mide falsos positivos y falsos negativos
Una IA demasiado sensible se convierte en un gallo a las tres de la mañana: técnicamente avisa, pero nadie la quiere cerca. Una IA demasiado permisiva llega cuando el incendio ya tiene página de estado. Ajusta umbrales, ventanas temporales y severidad de alertas según resultados reales.
Casos de uso reales: de la sospecha al diagnóstico 🕵️
Caso 1: El disco que crece en silencio
Un sitio recibe backups diarios y logs sin rotación adecuada. El monitoreo clásico avisa al 90% de uso de disco. La IA, en cambio, detecta que el ritmo de crecimiento se duplicó en las últimas 72 horas y predice agotamiento en cinco días. Acción: revisar rotación de logs, mover backups a almacenamiento externo, limpiar temporales y ajustar alertas. Incidente evitado.
Caso 2: WooCommerce lento después de una campaña
Una tienda lanza promociones por email. El tráfico sube, lo esperado. Pero el modelo detecta que la latencia del checkout aumenta más que el tráfico, y que las consultas lentas en tablas de pedidos se disparan. Acción: activar caché de objetos con Redis, revisar índices, desactivar plugins no esenciales durante campaña y escalar base de datos. La web no se cae. La caja registradora, ese animal delicado, sigue cantando.
Caso 3: Un plugin actualizado rompe el equilibrio
Tras una actualización, el consumo de memoria por proceso PHP aumenta un 35%. La CPU no está al límite, pero PHP-FPM empieza a acercarse a max_children. Un sistema AIOps correlaciona el cambio con el aumento de memoria y alerta antes de que aparezcan errores 502. Acción: rollback del plugin, reporte al proveedor, prueba en staging. Aquí la IA no fue oráculo; fue testigo con buena memoria.
Caso 4: Bots que imitan usuarios
El tráfico aumenta de forma gradual desde múltiples IPs. No parece un ataque volumétrico evidente. Sin embargo, la IA detecta un patrón extraño: muchas solicitudes a búsquedas internas, parámetros dinámicos y páginas sin caché. Acción: reglas WAF, rate limiting, bloqueo de patrones, protección de endpoints pesados. A veces el enemigo no derriba la puerta; simplemente toca el timbre cien mil veces.
Cómo combinar IA, seguridad y rendimiento web 🛡️⚡
La estabilidad del servidor no vive separada de la seguridad. Un ataque de fuerza bruta puede saturar PHP. Un escaneo agresivo puede llenar logs. Una vulnerabilidad explotada puede generar procesos extraños, envío de spam, consumo de CPU o conexiones salientes sospechosas. En otras palabras: la seguridad también tiene temperatura, pulso y presión arterial.
Por eso conviene integrar:
- WAF: Cloudflare, Sucuri, AWS WAF, ModSecurity u opciones equivalentes.
- Detección de bots: análisis de user agents, IPs, ASN, patrones de navegación y tasas de solicitud.
- Escaneo de malware: especialmente en WordPress, donde un archivo PHP escondido puede causar estragos discretos.
- Logs de autenticación: intentos fallidos, accesos administrativos, cambios de privilegios.
- Alertas de integridad: modificaciones inesperadas en archivos críticos.
Una plataforma avanzada puede correlacionar un aumento de errores, una subida de CPU y miles de intentos contra /wp-login.php. Sin esa correlación, cada señal parece una molestia aislada. Juntas, forman una escena del crimen.
Buenas prácticas para que la IA sea realmente útil ✅
El monitoreo predictivo no se instala como quien coloca una maceta en la ventana. Hay que cuidarlo. Ajustarlo. Enseñarle. Dejar que se equivoque un poco y corregirlo. Estas prácticas marcan la diferencia entre una plataforma brillante y un generador de ruido caro.
Etiqueta incidentes
Registra causa, duración, impacto y solución. Sin historial etiquetado, los modelos aprenden menos y el equipo repite errores con una fidelidad casi artística.
Monitorea percentiles
Usa p95 y p99 para latencia. El promedio oculta sufrimiento: si nueve usuarios cargan rápido y uno espera quince segundos, el promedio sonríe; el usuario no.
Incluye monitoreo sintético
Prueba rutas críticas desde distintas ubicaciones: home, login, checkout, APIs. No basta saber que el servidor vive; hay que saber si cumple su oficio.
Controla costes
Los logs pueden crecer como hiedra después de la lluvia. Define retención, muestreo, niveles de detalle y exclusiones inteligentes.
Usa entornos de staging
Las actualizaciones en producción sin prueba previa son una tradición antigua, como navegar sin mapa y sorprenderse del naufragio.
Automatiza respuestas seguras
Escalado automático, limpieza de colas, bloqueo de bots o activación de caché de emergencia pueden reducir impacto si están bien diseñados.
Errores frecuentes al usar IA para monitoreo de servidores ❌
Creer que la IA reemplaza al criterio técnico
La IA puede señalar patrones, pero alguien debe interpretar impacto, prioridades y riesgos. Un modelo puede decir que la memoria sube; un profesional entiende si conviene escalar, optimizar consultas, revisar fugas o reiniciar un servicio como medida temporal.
Monitorear demasiado poco
Si solo vigilas CPU, RAM y disco, verás la superficie. Muchos problemas reales ocurren en la capa de aplicación: consultas lentas, colas, APIs externas, locks, sesiones, caché rota. Es como mirar el mar y creer que entiendes las corrientes por el color de la espuma.
Monitorear demasiado sin gobernanza
El extremo opuesto también duele: capturar cada log, cada traza, cada evento, sin estrategia. Resultado: costes altos, paneles infinitos y alertas que nadie atiende. La observabilidad debe responder preguntas, no coleccionar datos por ansiedad.
No vincular alertas con acciones
Una alerta debe tener dueño, severidad y procedimiento. Si nadie sabe qué hacer, la notificación se convierte en decoración digital.
No revisar el modelo tras cambios importantes
Migraciones, rediseños, nuevas campañas, cambios de caché, versiones de PHP o modificaciones de arquitectura alteran el comportamiento normal. Si el modelo aprendió un mundo que ya no existe, seguirá opinando con seguridad, que es una de las formas más peligrosas de equivocarse.
Arquitectura recomendada para un sitio profesional 🌐
Para un sitio de negocio serio —especialmente ecommerce, membresías, medios digitales o plataformas con usuarios autenticados— una arquitectura razonable de monitoreo predictivo puede incluir:
- CDN y WAF: para absorber tráfico, bloquear amenazas y obtener métricas de borde.
- Monitoreo sintético: pruebas periódicas de rutas críticas desde varias regiones.
- APM: trazas de aplicación, consultas lentas, errores y dependencias externas.
- Métricas de infraestructura: CPU, RAM, disco, red, contenedores, procesos.
- Logs centralizados: servidor web, aplicación, seguridad, base de datos.
- Alertas con IA: anomalías, predicciones de capacidad, correlación de eventos.
- Panel ejecutivo: disponibilidad, rendimiento, ventas afectadas, SLO y estado general.
- Runbooks y escalado: procedimientos humanos y automatizaciones controladas.
No todo debe hacerse el primer día. Empieza por lo esencial: uptime externo, métricas del servidor, logs de errores y rutas críticas. Luego añade APM. Después, anomalías y predicción. La madurez operativa se construye por capas, como una ciudad antigua: cimientos, calles, murallas, plazas, alguna estatua innecesaria y, con suerte, buen alcantarillado.
Indicadores predictivos que deberías configurar cuanto antes 📌
| Indicador predictivo | Qué puede anticipar | Acción recomendada |
|---|---|---|
| Tiempo estimado hasta llenar disco | Caída por falta de espacio, errores de base de datos, logs interrumpidos. | Rotar logs, mover backups, ampliar volumen, revisar archivos temporales. |
| Tendencia de memoria y swap | OOM kills, lentitud extrema, reinicios de servicios. | Identificar procesos, revisar fugas, ajustar workers, escalar RAM. |
| Anomalía en latencia p95/p99 | Degradación de experiencia antes de caída visible. | Revisar APM, base de datos, caché, APIs externas. |
| Incremento de errores 5xx | Fallo de aplicación, saturación backend, problemas PHP-FPM o upstream. | Consultar logs, correlacionar despliegues, revisar recursos. |
| Cola PHP-FPM o workers agotados | Errores 502/504 y bloqueo de solicitudes. | Optimizar código, cachear, aumentar capacidad, revisar tráfico. |
| Consultas lentas anómalas | Saturación de base de datos y lentitud general. | Analizar slow query log, índices, plugins, tablas grandes. |
| Caída del cache hit ratio | Aumento de carga sobre PHP y base de datos. | Revisar reglas de caché, cookies, plugins, CDN y purgas excesivas. |
¿Y si tienes un VPS pequeño o hosting gestionado? 🧩
No todas las empresas tienen Kubernetes, microservicios o un equipo SRE bebiendo café frente a seis monitores. A veces hay un VPS, un panel Plesk o cPanel, WordPress, Cloudflare y una persona que hace “un poco de todo”, expresión heroica donde las haya.
Aun así, puedes aplicar monitoreo predictivo de forma pragmática:
- Usa un servicio externo de uptime con pruebas HTTP y alertas por email, SMS o Slack.
- Activa métricas del proveedor cloud o del panel de hosting.
- Configura logs de errores de PHP y servidor web.
- Instala una solución ligera como Netdata, Zabbix Agent, Grafana Agent, Elastic Agent o integraciones del proveedor.
- Configura Cloudflare Analytics y reglas contra bots.
- Usa un plugin de WordPress con cuidado para auditoría y salud, sin convertir el panel en un bazar de extensiones.
- Revisa semanalmente tendencias de disco, CPU, memoria y tiempos de respuesta.
Si el presupuesto es limitado, prioriza tres cosas: alertas tempranas de disponibilidad, visibilidad de recursos y logs centralizados. No es perfecto, pero es infinitamente mejor que descubrir una caída por una llamada de ventas.
Preguntas frecuentes sobre IA para predecir caídas de servidores 💬
¿La IA puede evitar todas las caídas?
No. Puede reducir riesgo, anticipar patrones peligrosos y acelerar diagnóstico, pero no elimina fallos de hardware, errores humanos, bugs imprevistos, ataques sofisticados o interrupciones de proveedores. La alta disponibilidad se construye con monitoreo, arquitectura, procesos y pruebas.
¿Cuánto historial necesito para que funcione?
Para anomalías básicas, algunos días pueden bastar. Para predicciones más fiables, conviene tener al menos 30 días. Para estacionalidad real, campañas y patrones de negocio, 90 días o más ofrecen mejores resultados.
¿Sirve para WordPress?
Sí, especialmente si se monitoriza más allá del uptime: PHP-FPM, base de datos, plugins, caché, WooCommerce, logs de errores, tráfico bot y rutas críticas. WordPress no necesita menos observabilidad por ser popular; suele necesitar más, precisamente por su ecosistema amplio.
¿Qué diferencia hay entre APM y AIOps?
APM se centra en rendimiento de aplicaciones: trazas, errores, consultas, tiempos de respuesta. AIOps es más amplio: usa automatización y análisis inteligente para correlacionar eventos, reducir ruido, detectar anomalías y apoyar operaciones de TI.
¿Puedo usar herramientas gratuitas?
Sí. Prometheus, Grafana, Loki, OpenTelemetry, Netdata y Zabbix pueden formar una base potente. El coste aparece en tiempo de configuración, mantenimiento, almacenamiento y conocimiento técnico. Gratis no siempre significa barato; solo cambia la moneda.
La parte humana de predecir fallos
Hace años, en una cafetería pequeña, vi al dueño apagar la máquina de espresso antes de que fallara. Nadie más había notado nada. “Suena distinto”, dijo. No era superstición; era experiencia. Había escuchado la máquina durante años. Sabía distinguir el zumbido normal de ese temblor diminuto que anuncia problemas. Me acordé de eso la primera vez que vi una buena plataforma de observabilidad detectar una anomalía antes de una caída. La tecnología, en el fondo, estaba aprendiendo a escuchar.
Ese es el verdadero valor de la IA aplicada a servidores: convertir ruido en señal. No reemplaza el oficio; lo amplifica. No elimina la necesidad de buenos desarrolladores, administradores o responsables de mantenimiento web; les da mejores ojos, mejores oídos y, a veces, unos minutos preciosos antes del golpe.
Porque la disponibilidad no es un estado pasivo. Es una negociación permanente entre tráfico, código, infraestructura, seguridad y azar. De un lado, la promesa luminosa de la web siempre abierta. Del otro, la materia humilde: discos que se llenan, procesos que se cuelgan, consultas que tardan, humanos que actualizan plugins un viernes por la tarde —la civilización avanza, claramente—.
La mejor estrategia no es esperar a que el servidor grite, sino aprender a reconocer cuándo empieza a susurrar. Con métricas correctas, herramientas de IA bien configuradas, alertas predictivas y procedimientos claros, una caída deja de ser una sorpresa inevitable y se convierte en un riesgo gestionable. No es magia. Es disciplina con buenos sensores. Y en internet, eso ya se parece bastante a la prudencia.